「最新ニュースや競合サイトの調査を、AIに24時間定期的に自動巡回させたい」
「でも、クラウドのAPIを常時ポーリングし続けると、毎月の従量課金(トークン代)が跳ね上がるのが怖い……」
「それに、社外秘のメモや個人のプライベートなデータをクラウドに送りたくない……」
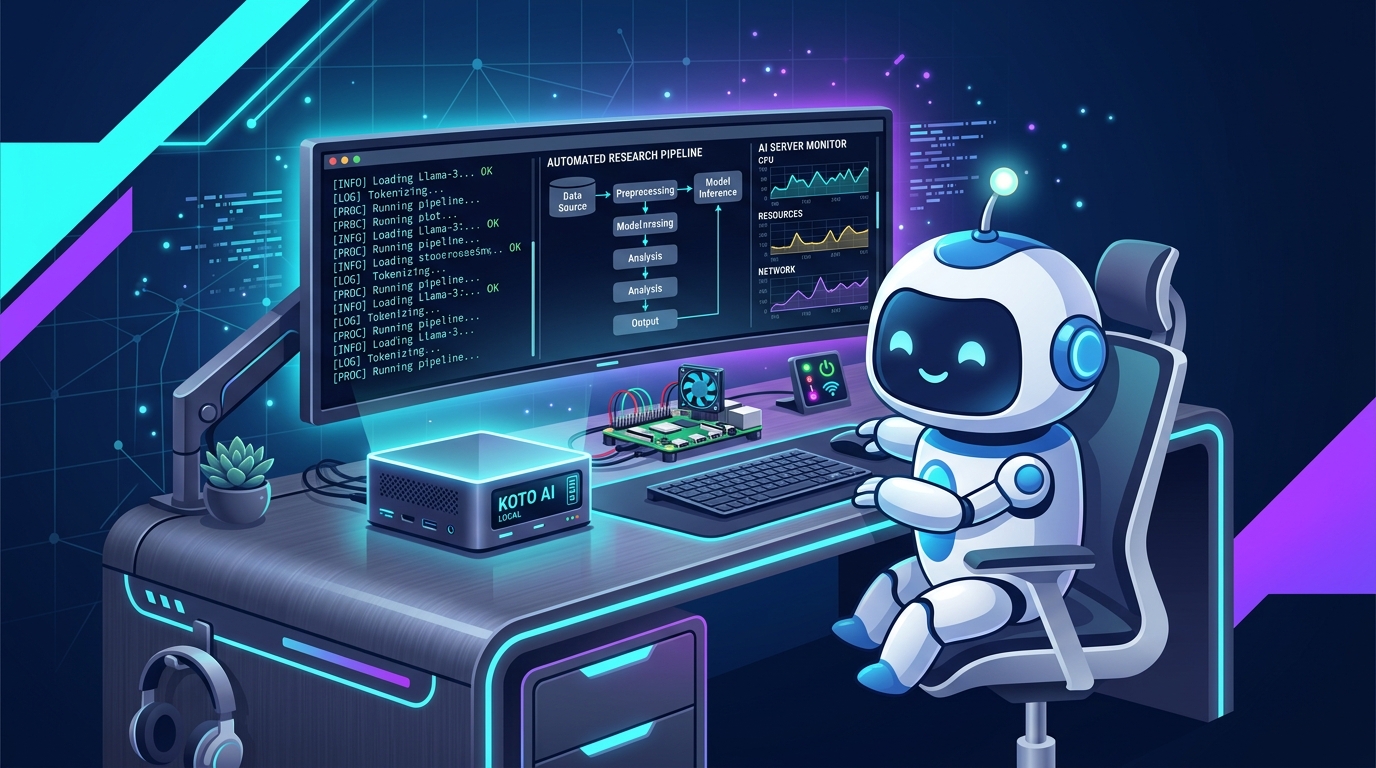
そんな悩みを抱えている方に今最もおすすめしたいのが、手のひらサイズの省電力ミニPCやRaspberry Piで組む「自宅ローカルAI自律エージェントサーバー」です。
2026年現在、オープンソースの小型LLM(3B〜8Bクラス)の推論性能は飛躍的に進化し、GPUを積んでいない数万円の省電力ミニPCでも、日本語の要約やリサーチが実用水準でサクサク動作するようになりました。
本記事では、ハードウェアの選定、月々のリアルな電気代、Ollamaを使った超簡単セットアップ、そして夜間に勝手に情報収集を終わらせてくれる自律化ワークフローの実践例まで、分かりやすく完全解説します!
🧭 1. なぜ今「自宅ローカルAIサーバー」なのか?(クラウドとの比較)
普段のチャットであればChatGPTやClaudeなどのクラウドサービスが便利ですが、「24時間365日常駐させてバックグラウンド処理をさせる」となると、ローカルサーバーが圧倒的な強みを発揮します。
| 比較項目 | クラウドAPI(従量課金) | 自宅ローカルAI(小型PC) |
|---|---|---|
| 利用料金 | 使った分だけ従量課金(巡回させると高額) | 完全定額(電気代月200〜300円のみ) |
| トークン制限 | レートリミット(回数制限・分間制限)あり | 無制限(何百万トークンでも回し放題) |
| プライバシー | 外部サーバーへテキストを送信 | 完全閉域(家庭内LANから外に出ない) |
| 推論速度 | 爆速(クラウド巨大GPU) | 3B〜8Bモデルなら実用水準(15〜30 tokens/s) |
🖥️ 2. ハードウェア選定と電気代のリアル(ミニPC vs Raspberry Pi 5)
自宅サーバーと聞くと「大きなタワーPC」「高価なグラフィックボード」「爆音ファン」を想像するかもしれませんが、現在の軽量LLMであれば手のひらサイズの省電力マシンで十分です。
気になる「24時間つけっぱなし」の電気代は?
- アイドル時(待機中 6W): 6W × 24h × 30日 = 約4.3kWh ➔ 月額 約133円
- リサーチ実行時(平均 12W): 12W × 24h × 30日 = 約8.6kWh ➔ 月額 約267円
※クラウドの有料APIやサブスク(月$20=約3,000円)と比べても、月額わずか缶ジュース2本分の電気代で常時稼働エージェントが手に入ります!
⚙️ 3. ソフトウェア構成とおすすめ軽量モデル(3B〜8B)
ローカルAIサーバーの構築は驚くほど簡単です。オープンソースの推論エンジン「Ollama(オラマ)」を使えば、コマンド1行でAPIサーバーが立ち上がります。
curl -fsSL https://ollama.com/install.sh | sh
# おすすめモデルをダウンロードして即起動
ollama run qwen2.5:7b
2026年最新:小型PCで爆速動作する厳選3大モデル
- 🥇 Qwen 2.5 (3B / 7B): 【日本語要約・整理の最強王者】中国Alibaba開発ながら、日本語の文脈理解力と構造化(JSON出力)が極めて優秀。ニュース要約やタスク抽出に最もおすすめ。
- 🥈 Llama 3.2 (3B): 【Metaの超軽量高速モデル】メモリ消費がわずか2GB台。Raspberry Pi 5でも秒間20トークン以上で爆速稼働。
- 🥉 DeepSeek-R1-Distill-Qwen-7B / 8B: 【推論・コード解析特化】「なぜその結論に至ったか」を論理的に思考してから答えるため、複雑なデータ分析やPythonスクリプトのレビューに最適。
🚀 4. 24時間自律稼働ワークフローの実践例(夜間自動リサーチ)
自宅サーバーを立てたら、Cron(定期実行スケジューラ)やPythonスクリプトと連携させて「寝ている間に仕事を終わらせる自律パイプライン」を組みます。
- 深夜 2:00(データ収集): Pythonスクリプトが国内外の主要AIメディア・RSS・GitHub Trendingを自動巡回し、最新記事の本文をスクレイピング。
- 深夜 2:30(ローカルLLM要約): 自宅サーバーのOllama(Qwen 2.5 7B)に記事テキストを渡し、「3行要約 + 重要度(★1〜5) + 関連タグ」をJSON形式で抽出。
- 深夜 3:00(ナレッジ蓄積): 要約結果をNotionのデータベースやMarkdownファイルへ自動追記。
- 朝 7:00(レポート通知): DiscordまたはSlackの専用チャンネルに「本日の注目AIトピック Top 5」が自動通知される。
朝起きてスマホを開くと、すでに今日のテックニュースや重要トレンドが綺麗に要約されて届いているため、毎朝の情報収集時間が実質ゼロ分になります。
🛡️ 5. 導入時の注意点・安全運用のコツ
自宅サーバーを長期間安定して稼働させるための3つのポイントです。
- ① 熱対策と静音性: ミニPCは窒息ケースを避け、底面・側面に通気口があるモデルを選びましょう。ファン回転数をBIOSで「静音モード」にしておけば、寝室の近くに置いても音は気になりません。
- ② ストレージはNVMe SSDを選ぶ: モデルファイルの読み込み速度に直結します。microSDカード(ラズパイの場合)は書き込み劣化しやすいため、USB経由の外部SSD化がおすすめです。
- ③ 外部公開はせず「Tailscale」を使う: 自宅サーバーを外出先のスマホやノートPCから叩く際、ルーターのポート開放(ポートフォワーディング)はセキュリティ上危険です。無料のメッシュVPN「Tailscale」を入れれば、安全な暗号化トンネル経由でどこからでもローカルAIにアクセスできます。
💡 まとめ & コトの考察:手元に「24時間働くAI社員」を置く贅沢
クラウド全盛の時代にあえて「自宅ローカルAIサーバー」を組む最大の魅力は、「コストの不安なく、自分の思い通りのペースでAIを24時間働かせ続けられる自由」にあります。
月数百円の電気代だけで、文句も言わずに夜通しリサーチやデータ整理をこなしてくれる相棒が物理的にデスクの片隅で光っている体験は、エンジニアやクリエイターにとって大きな実利とワクワク感を与えてくれます。
余っている小型PCや手頃なミニPCがある方は、ぜひ「自分専用のAIエージェントサーバー」を構築してみてください!
✍️ 記事制作について(E-E-A-T対応): 本記事は運営者(コト)の実機検証・省電力測定・自律化スクリプト構築の実績に基づき構成しています。詳しい制作ポリシーは当サイトのポリシーページをご覧ください。